トランスレーショナルリサーチのデータ解析手法と臨床をつなぐ課題
2026年現在の医療・ライフサイエンス分野において、基礎研究の成果を実際の臨床現場へスピーディーに還元するアプローチは、新薬開発や先端医療の成否を握る極めて重要な鍵となっています。その中核を担うのが、実験室のディスカバリーとベッドサイドの治療を結ぶ架け橋としての役割を持つトランスレーショナルリサーチです。膨大な生命科学データを統合し、確かなエビデンスを構築するためのデータ解析は、現代の医療イノベーションにおいて欠くことのできないプロセスとして注目を集めています。
本記事では、基礎研究と臨床試験の間をつなぐデータ解析の仕組みや、最先端のバイオインフォマティクスが果たす役割、そして現場が直面している課題とその解決に向けたアプローチについて、専門的な視点からわかりやすく解説します。
📌 【この記事の重要ポイントまとめ】
- 要点1:トランスレーショナルリサーチにおけるデータ解析は、基礎研究の知見を臨床試験へ橋渡しする中核プロセスである。
- 要点2:マルチオミクス解析やバイオマーカーの特定により、医薬品開発の精度向上と個別化医療の実現が加速している。
- 要点3:データ標準化の遅れや異種データの統合といった課題に対し、高度な統計解析手法や標準規格の適用が求められている。
トランスレーショナルリサーチとデータ解析の全体像
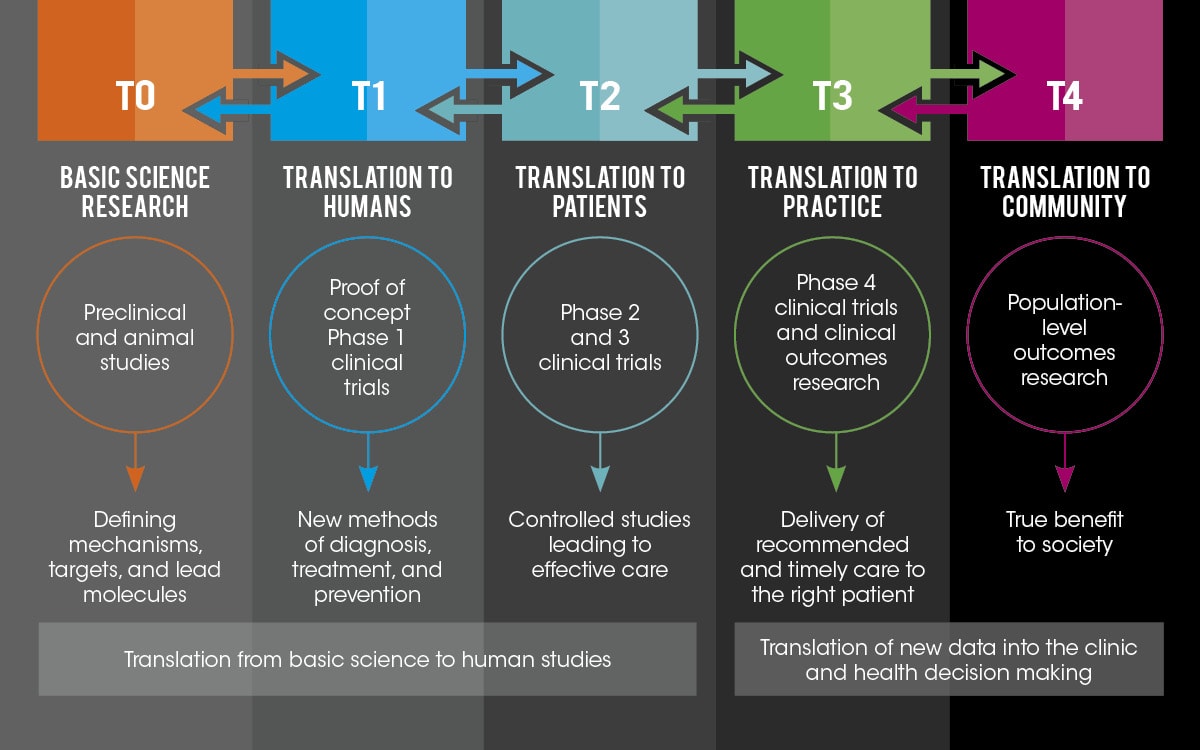
トランスレーショナルリサーチとは、基礎医学研究で見出された新しい科学的発見やシーズを、ヒトを対象とした臨床研究や臨床試験へと応用し、最終的に患者の治療法や診断法として還元する一連のプロセスを指します。この双方向の循環において、実験データと臨床データを適切に結びつけるのが高度なデータ解析です。
従来の医薬品開発や臨床試験では、個別の仮説検証に特化した限られたデータの解析が主流でした。しかし、近年の技術革新に伴い、遺伝子発現プロファイル、タンパク質構造、臨床電子カルテ(EHR)などの多様かつ膨大なデータが生成されるようになりました。これらを俯瞰的に解析し、治療効果や安全性を予測するためのエビデンス構築が、研究現場の最前線で行われています。

前臨床から臨床試験を支える主要な研究手法とデータ解析
創薬や先端医療の開発プロセスにおいて、前臨床試験から臨床試験への移行は非常に高いハードルが存在します。動物モデルなどの前臨床段階で得られた膨大な実験データが、実際のヒト臨床においてどのように機能するかを予測するためには、体系的な統計解析およびバイオインフォマティクスのアプローチが不可欠です。
特に近年では、ゲノム、トランスクリプトム、プロテオームなどのマルチオミクスデータを統合的に解析する手法が標準化されつつあります。これにより、単一の指標では捉えきれなかった複雑な生体反応や疾患メカニズムの全体像を可視化することが可能となり、開発リスクの低減に大きく貢献しています。
トランスレーショナルリサーチにおける主要解析手法と役割
| 解析プロセス | 主な対象データ | 目的・果たす役割 |
|---|---|---|
| 前臨床データ解析 | 動物実験データ、細胞株スクリーニング結果 | 薬効の初期評価、安全性・毒性の予測、有効性の検証 |
| マルチオミクス解析 | ゲノム、トランスクリプトム、メタボローム等 | 疾患関連因子の網羅的探索、複雑な病態の解明 |
| バイオマーカー探索 | 生体試料分子データ、臨床応答データ | 治療効果の予測、患者層別化、個別化医療の確立 |
| 臨床試験統計解析 | EHR、治験被験者の臨床パラメータ | 有効性と安全性の検証、規制当局へのエビデンス提出 |
バイオインフォマティクスとバイオマーカーの重要性
トランスレーショナルリサーチの成否を分ける要素の一つが、高精度なバイオマーカーの特定と、それを支えるバイオインフォマティクス(生物情報科学)の活用です。バイオマーカーは、特定の疾患の存在や進行度、あるいは薬剤に対する反応性を客観的に評価するための指標として機能します。
例えば、がん免疫療法や分子標的薬の開発においては、特定の遺伝子変異やタンパク質発現を持つ患者群を正確に特定することが不可欠です。バイオインフォマティクスを用いた高度な統計解析により、ノイズの多い臨床・基礎データの中から意味のあるシグナルを抽出し、治験の成功確率を高めるための患者層別化(ストラティフィケーション)が実現されています。
臨床・基礎研究をつなぐプロセスにおける主要な課題
医療データや研究データの活用が進む一方で、トランスレーショナルリサーチの現場ではいくつかの深刻な課題も指摘されています。その筆頭が、データのサイロ化と標準化の不足です。
基礎研究室で取得される生データと、医療機関の電子カルテシステムに蓄積される臨床データでは、データフォーマットや管理基準が大きく異なります。これらの異種データを統合し、一貫したトレーサビリティを確保するためには、共通のデータ標準規格(例えば、医療情報の国際標準であるHL7 FHIRや、文書・翻訳データの相互運用性を高める各種フォーマット規格の思想)に準拠した基盤整備が急務となっています。
また、解析を担うデータサイエンティストやバイオインフォマティシャンの不足、および医学・生物学の専門知識と統計解析スキルの双方を兼ね備えた人材の育成も、今後の持続的な研究開発において解決すべき重要な課題です。
【translational research data analysis】に関するよくある質問(FAQ)
Q1:トランスレーショナルリサーチのデータ解析において、マルチオミクス解析はどのようなメリットをもたらしますか?
A1:遺伝子、タンパク質、代謝物などの異なる階層のデータを統合解析することで、単一の視点では見落とされていた複雑な疾患メカニズムや薬剤応答の全体像を明らかにすることができ、より精度の高いバイオマーカーの発見につながります。
Q2:基礎研究のデータと臨床試験のデータを統合する際の最大の障壁は何ですか?
A2:データ形式の不統一や、施設ごとに異なる管理システム(データのサイロ化)が主な障壁です。統一された標準規格やセキュアなデータ統合プラットフォームの構築が求められています。
Q3:企業や研究機関がデータ解析を高度化するために必要な条件は何ですか?
A3:最新の統計解析ツールの導入に加え、医療データ規制(プライバシー保護など)への厳格な準拠、そして医学・統計・ITの領域を横断して理解できる専門人材の確保が不可欠です。

まとめ:今後の動向とエビデンス構築の展望
トランスレーショナルリサーチにおけるデータ解析は、単なる数値処理の枠を超え、次世代の医療と創薬のスピードを決定づける戦略的基盤となっています。マルチオミクスやAI技術の進化により、基礎研究から臨床試験への移行プロセスはより高度で効率的なものへと進化しつつあります。
今後は、データの標準化やセキュリティを担保しながら、異分野間のコラボレーションを深化させることが求められます。正確で信頼性の高いエビデンス構築を継続していくことが、患者一人ひとりに最適な医療を届けるための最も確実な道筋といえます。 (出典: translational research data analysis(Yahoo!ニュース))
Webメディアの編集およびコンテンツ作成に従事。正確で質の高い情報発信を心掛けています。
